この記事でわかること
- 生成AIと著作権を「学習段階」と「生成・利用段階」に分けて整理する考え方
- 生成物が著作権侵害になる条件(類似性 × 依拠性)と、実務での避け方
- 他人の著作物を「引用」として扱うための5つの要件(著作権法32条・48条)
- AI利用の開示ルールの最新動向(EU AI法 第50条/日本のAI新法)と公開前チェックリスト
生成AIの著作権は「学習させるとき」と「出力を世に出すとき」で別のルールが動きます。学習は日本の著作権法30条の4で原則許諾不要。一方、出力の公開は通常の著作権侵害と同じ「類似性 × 依拠性」で判断されます。そして、AIの出力そのものは「引用」ではありません。守るべきは、①固有名詞をプロンプトに入れない ②公開前に類似チェック ③出典とAI利用を明示する、の3点です。
生成AIと著作権は「2つの段階」で考える.
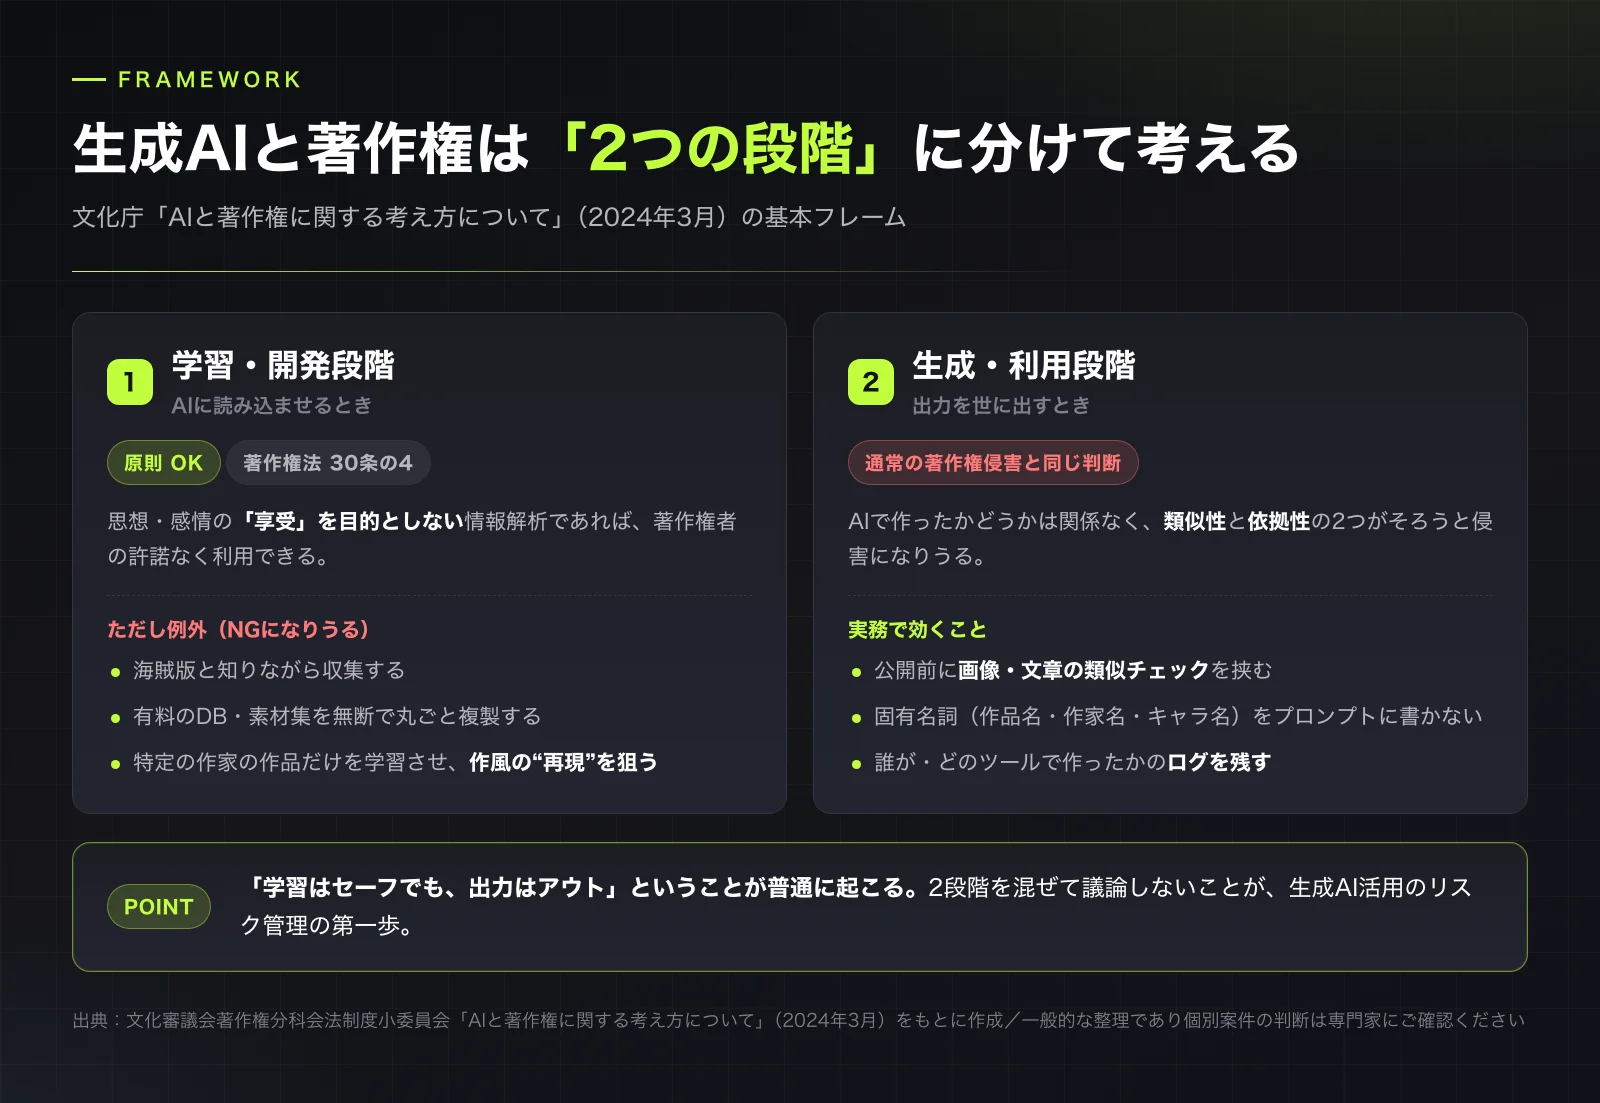
生成AIの著作権をめぐる議論が噛み合わないのは、性質のまったく違う2つの場面が混ぜて語られているからです。文化庁の文化審議会著作権分科会法制度小委員会が2024年3月にまとめた「AIと著作権に関する考え方について」も、この2段階を前提に整理されています。
① 学習・開発段階(AIに読み込ませるとき)
AIモデルを学習させるために著作物を複製・解析する場面です。日本では著作権法30条の4により、思想・感情の「享受」を目的としない利用は原則として許諾なく行えるとされています。世界的にも緩やかな部類のルールで、日本が「AI開発に寛容な国」と言われる根拠になっています。
② 生成・利用段階(出力を世に出すとき)
できあがった画像や文章を広告・記事・商品に使う場面です。ここには特別扱いがありません。AIで作ったかどうかに関係なく、通常の著作権侵害と同じ基準で判断されます。
つまり「学習は合法だから、出力も自由に使える」は成立しません。実務でトラブルになるのは、ほぼ例外なく②の場面です。
① 学習段階のルール|著作権法30条の4と「不当に害する場合」.
30条の4は広い権利制限規定ですが、無制限ではありません。条文には「著作権者の利益を不当に害することとなる場合は、この限りでない」という但し書きがあります。文化庁の考え方では、次のようなケースが適用外になりうるとされています。
| 場面 | 原則の扱い | 判断のポイント |
|---|---|---|
| 一般に公開されている画像・文章を大量に解析する | 許諾不要になりやすい | 享受目的がなく、情報解析に該当する |
| 海賊版サイトだと知りながら収集する | リスクが高い | 著作権者の利益を不当に害すると評価されやすい |
| 有料の学習用データベースを無断で複製する | リスクが高い | データベース自体の販売市場と競合する |
| 特定の作家の作品だけを学習させ、その作風の再現を狙う | リスクが高い | 創作的表現の出力が目的なら「享受目的が併存」と評価されうる |
| 社内資料・契約で利用範囲が制限されたデータを学習に流用する | リスクが高い | 著作権とは別に契約違反・秘密保持の問題になる |
「作風」や「画風」そのものはアイデアであり、著作権では保護されません。ただし、特定の作家の作品だけを集中的に学習させる行為は、学習段階で30条の4の適用外と評価される可能性があります。「作風は自由」と「特定作家の学習は自由」は別の話だと考えてください。
② 生成・利用段階のルール|「類似性」×「依拠性」で決まる.
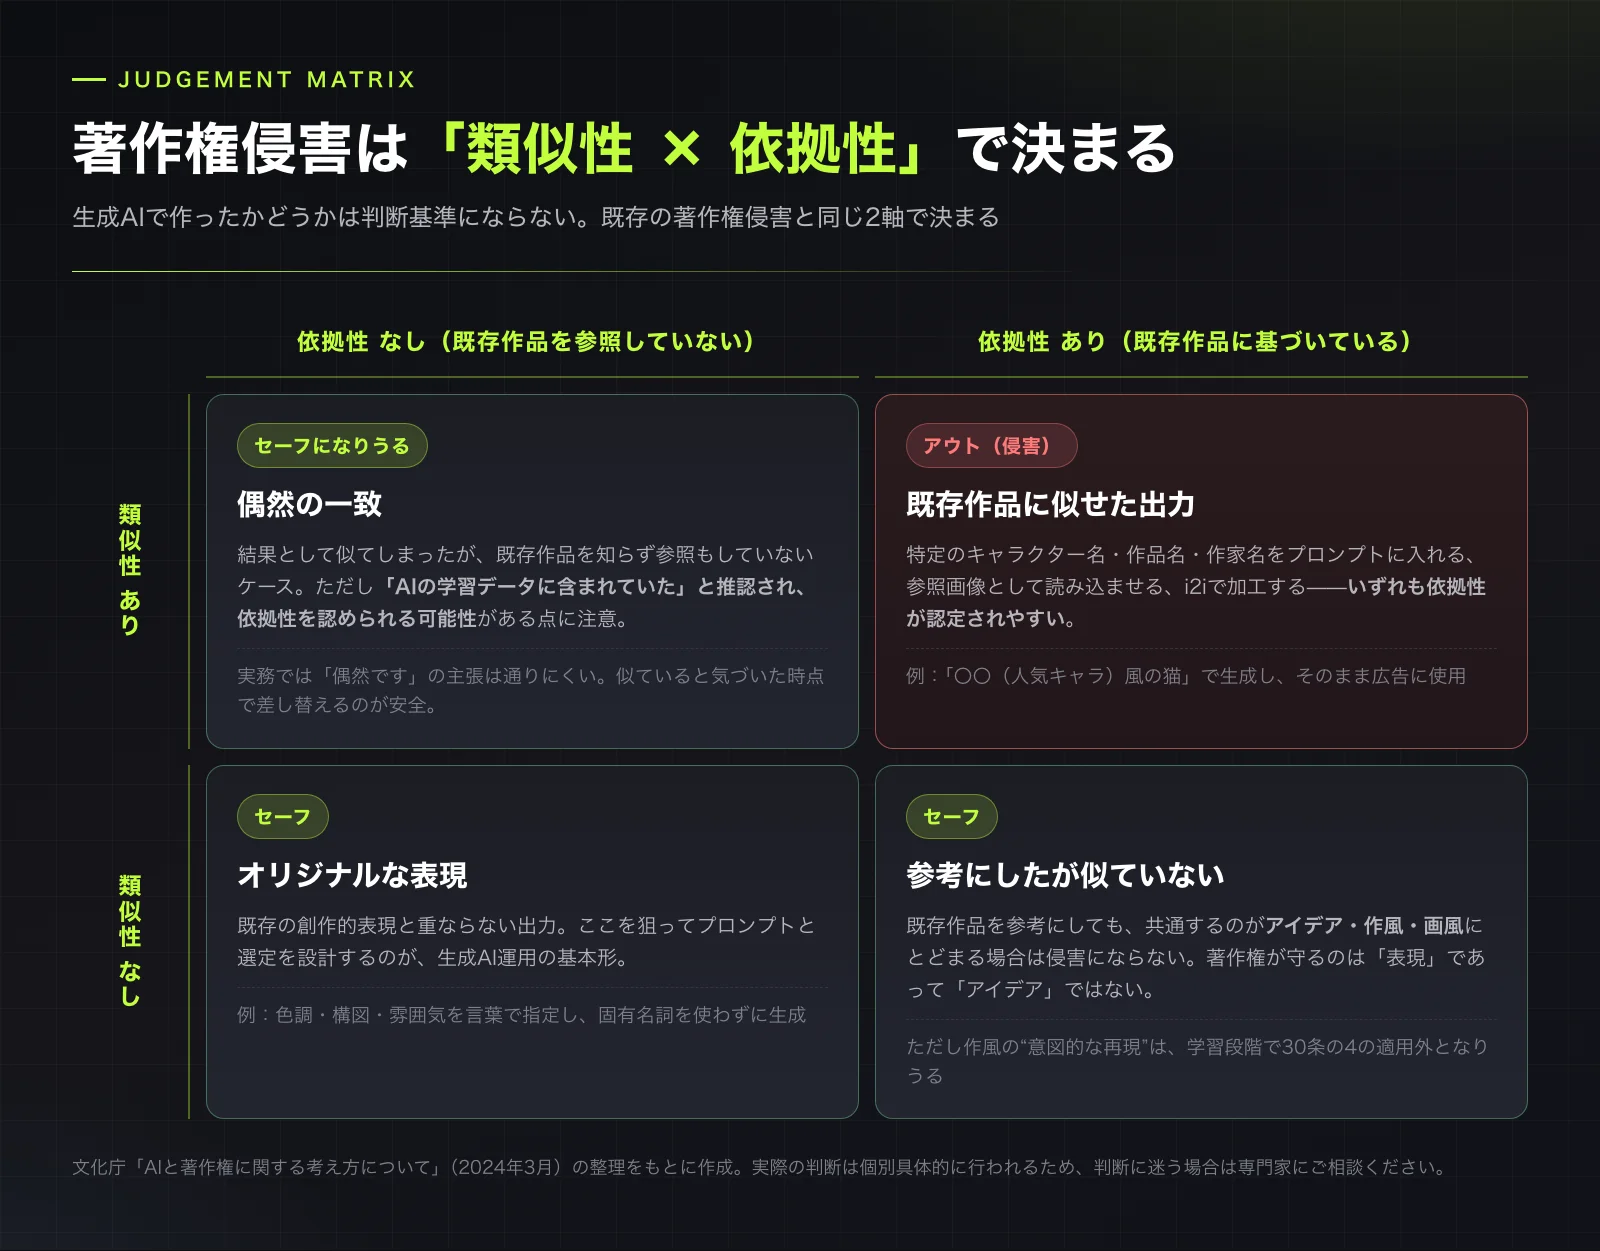
出力した画像や文章が著作権侵害になるかどうかは、次の2つがそろうかどうかで決まります。
類似性|表現が似ているか
既存の著作物と「創作的表現」が共通しているかどうか。ここで重要なのは、著作権が守るのは表現であって、アイデアや作風ではないという点です。「サイバーパンクな街並み」「淡い水彩タッチ」といった方向性が同じでも、それだけでは侵害になりません。
依拠性|既存作品に基づいているか
その作品を参考にして作ったか。生成AIで難しいのがここです。利用者本人が元作品を知らなくても、学習データに含まれていたことを理由に依拠性が推認される可能性があると整理されています。「知りませんでした」が通りにくい構造になっている、と考えておくのが安全です。
実務でやるべきことは3つ
- 固有名詞をプロンプトに書かない:作品名・キャラクター名・作家名は、依拠性を自ら証明してしまう材料になります
- 公開前に類似チェックを挟む:画像検索・逆引き検索で「似すぎているもの」がないかを確認します
- 生成ログを残す:いつ・誰が・どのツールで・どんなプロンプトで作ったかを記録しておくと、依拠性がないことの説明材料になります
生成AIの出力を「引用」できるのか.
ここが混乱しやすいポイントです。結論から言うと、「AIの出力を引用する」という言い方自体が、法律上はズレています。
著作権法上の「引用」(32条1項)は、他人の著作物を自分の著作物の中で使うための規定です。AIが自律的に生成した出力には通常、著作物性が認められません。著作物でないものを使うのに、引用の要件を満たす必要はないのです。
問題になるのは逆の方向です。AIの出力の中に、他人の著作物がそのまま混ざっていた場合。このとき責任を負うのは、AIではなく、それを公開したあなたです。「AIが出力したから」は免責理由になりません。
だからこそ、生成AIを使って記事や資料をつくるときほど、引用のルールを正確に押さえておく必要があります。
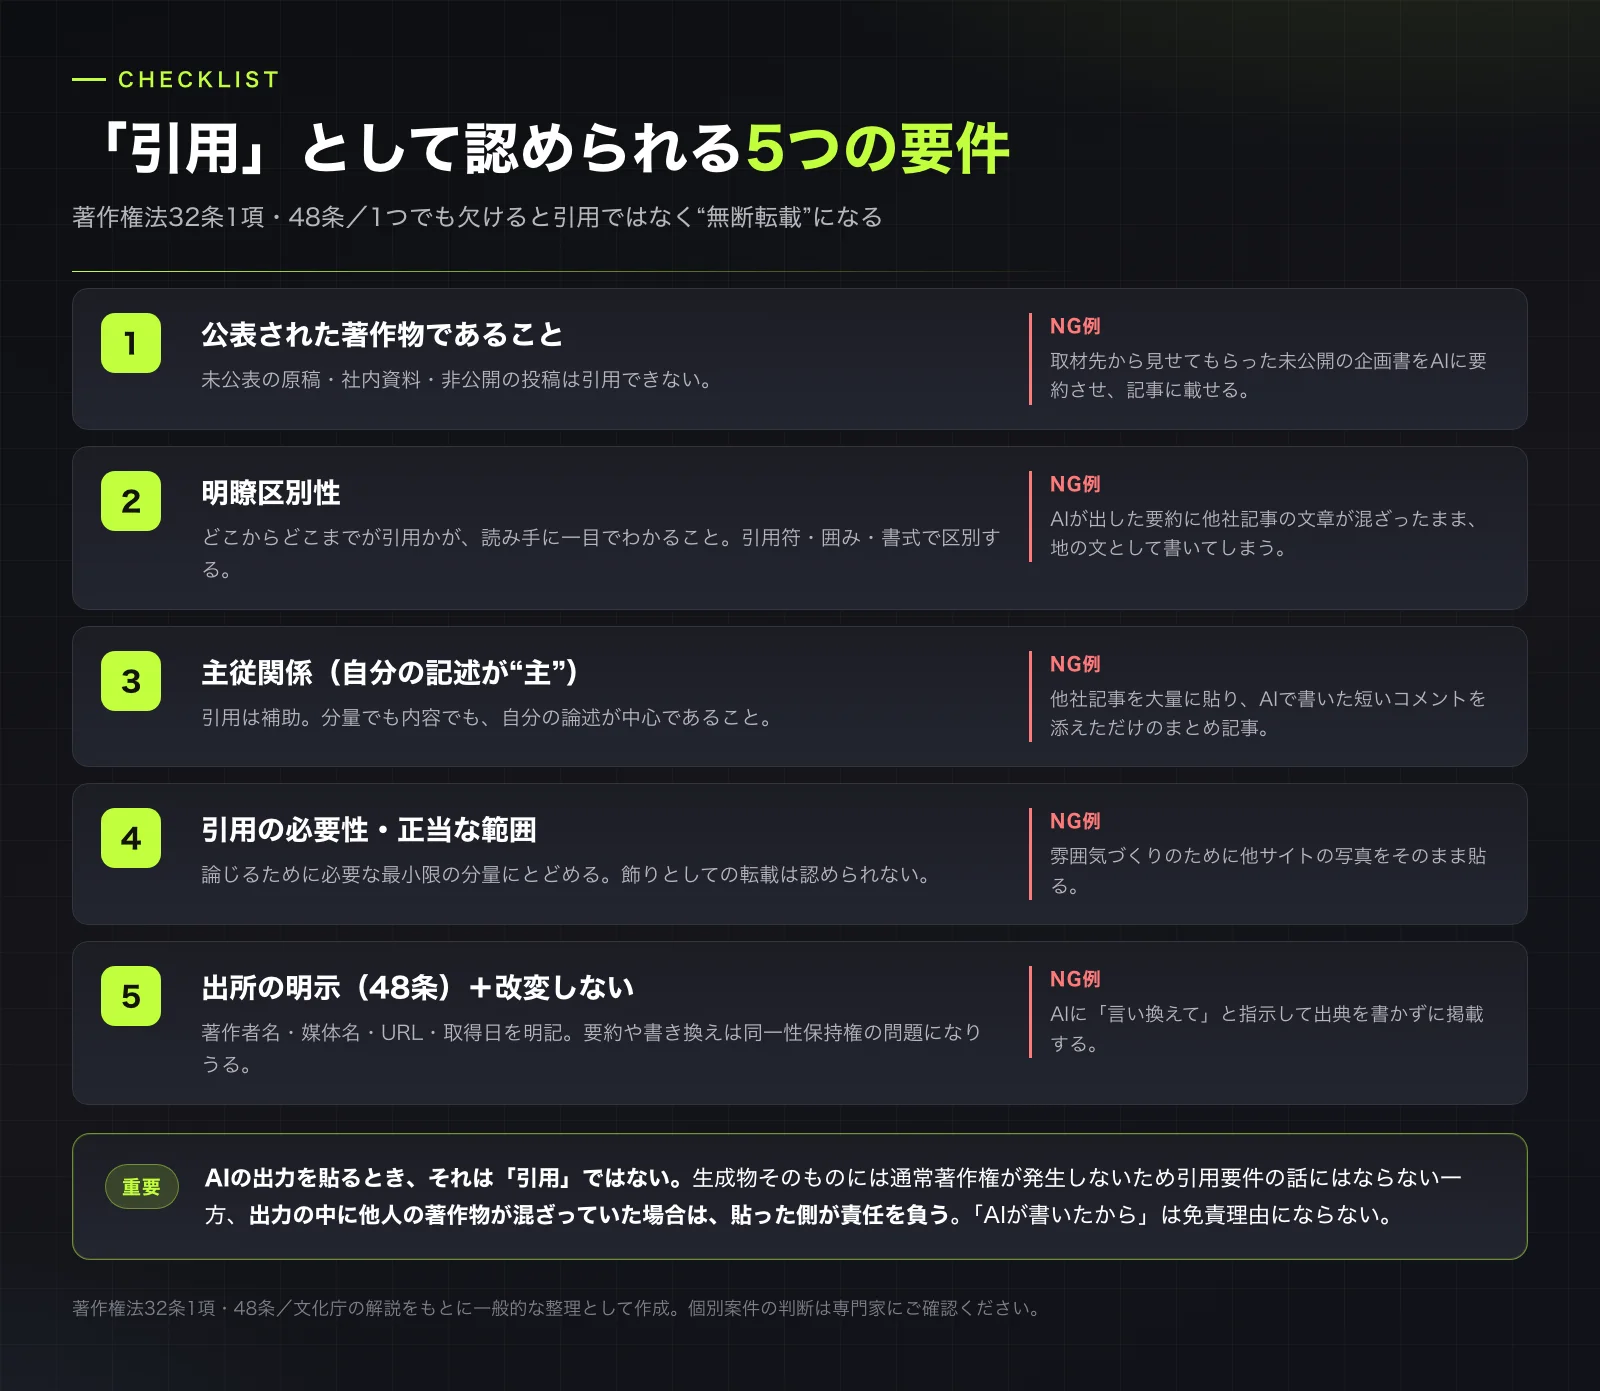
引用の5要件(著作権法32条1項・48条)
- 公表された著作物であること:未公表の原稿や非公開資料は引用できません
- 明瞭区別性:どこからどこまでが引用かが一目でわかること。引用符や囲みで区別します
- 主従関係:自分の記述が「主」、引用が「従」であること
- 必要性・正当な範囲:論じるために必要な最小限にとどめること
- 出所の明示(48条)と無改変:著作者名・媒体名・URL・取得日を明記し、勝手に書き換えないこと
生成AIを使う現場で特に危ないのが2つ目と5つ目です。AIに「要約して」「言い換えて」と指示した結果を地の文に混ぜると、明瞭区別性が失われ、出所も示されず、さらに改変まで加わっているという三重の問題になります。
以下の記事の要点を、私が理解するために箇条書きで整理してください。
記事本文をそのまま引用せず、事実関係だけを抽出してください。
出典として、媒体名・記事タイトル・URLを最後にまとめてください。
AI利用の「開示」はどこまで必要か|2026年の最新動向.
著作権とは別の軸として、2025年から2026年にかけて「AIで作ったことを明示する」ルールの整備が進みました。制作物を海外にも配信する企業は、こちらも押さえておく必要があります。
| ルール | 時期 | 内容 |
|---|---|---|
| EU AI法 第50条(透明性義務) | 2026年8月2日から適用 | AIとの対話、AI生成・加工されたコンテンツ、ディープフェイクについて開示が義務づけられる。違反時の制裁金は最大1,500万ユーロ、または全世界年間売上高の3%のいずれか高い方 |
| 欧州委員会のガイドライン | 2026年7月20日公表 | 第50条の最終ガイドラインを公表。AI生成コンテンツの透明性に関する行動規範も適切と確認された |
| 日本のAI新法(人工知能関連技術の研究開発及び活用の推進に関する法律) | 2025年6月4日公布/2025年9月1日全面施行 | 罰則を伴う規制法ではなく推進型。権利利益を侵害する事案の調査、事業者への指導・助言の仕組みを設ける |
| 文化庁「AIと著作権に関する考え方について」 | 2024年3月 | 法令ではないが、学習段階・生成利用段階の判断枠組みを示した実務上の基準 |
日本国内では、現時点でAI生成物への表示を一律に義務づける法律はありません。ただし、EU域内に広告や商品を出す場合はEU AI法の対象になりえます。また、法律以前の問題として「黙って使っていた」ことが後から発覚するほうが、はるかに大きなダメージになります。
迷ったら開示する。これが2026年時点でもっとも安全な運用です。
実際に起きた事例から学ぶ.
海外では、AIの学習データをめぐる大型訴訟が続いています。日本の実務にそのまま当てはまるわけではありませんが、「どこが争点になるのか」を知る材料になります。
| 事例 | 争点 | 実務への示唆 |
|---|---|---|
| Anthropic と著作者らの和解(米国/2026年7月20日に最終承認) | 書籍を海賊版サイトから取得して学習に使ったこと。和解額は15億ドル | 「AI学習そのものが違法」と判断されたわけではない。問題は学習データの入手経路にあった |
| The New York Times 対 OpenAI・Microsoft(米国) | 数十万本の記事が無断で学習に使われ、有料コンテンツ事業を損なったとする主張 | 報道コンテンツの学習利用は各国で議論が続いている。出力が元記事に酷似する事態は避ける必要がある |
| Getty Images 対 Stability AI | 1,200万点を超える画像の無断利用と、生成画像へのウォーターマーク再現 | 生成物に元素材の痕跡(透かし・署名)が出る場合、依拠性の強い証拠になりうる |
共通して見えてくるのは、「どこからデータを取ってきたか」と「出力に元作品の痕跡が残っていないか」という2点です。ツールを選ぶときは、学習データの出所を公表しているか、商用利用時の補償制度があるかを必ず確認してください。
生成AIの制作フローを、権利面まで含めて整えたい方へ.
公開前チェックリスト|この10項目を通せば事故はほぼ防げる.
生成AIコンテンツ 公開前チェック
Checklist- プロンプトに作品名・キャラクター名・作家名などの固有名詞を入れていない
- 参照画像を読み込ませた場合、その画像の権利を自社で持っている
- 使用したツールの利用規約で、商用利用が認められていることを確認した
- 画像検索・逆引き検索で、既存作品との類似がないか確認した
- 出力に透かし・署名・ロゴのような痕跡が残っていない
- 実在の人物・ブランドに似ていないか、第三者の目で確認した
- 記事に他人の著作物を載せる場合、引用の5要件を満たしている
- 出典(著作者名・媒体名・URL・取得日)を明記した
- 数値・法令・製品情報などの事実は一次情報で裏取りした
- 誰が・いつ・どのツールで・どのプロンプトで作ったかのログを保管した
チェックリストは「担当者の心がけ」ではなく、公開フローの中に組み込んでください。入稿前の必須項目にしてしまうのがもっとも確実です。
よくある質問.
Q生成AIで作った画像に著作権は発生しますか?
QAIが出力した文章をそのまま記事に載せてもいいですか?
Q「〇〇(作家名)風」というプロンプトは違法ですか?
Q記事にAIで作った画像を使う場合、AI生成であることを書く必要はありますか?
Q社内資料をAIに読み込ませるのは問題ありませんか?
Q万が一、著作権侵害を指摘されたらどうすればいいですか?
まとめ|ルールを知れば、生成AIはむしろ安全に速く使える.
要点を整理します。
- 生成AIと著作権は、学習段階と生成・利用段階に分けて考える
- 学習は30条の4で原則許諾不要。ただし海賊版・有料DBの無断利用・特定作家の作風再現はリスクが高い
- 出力の公開は類似性 × 依拠性で判断される。AIで作ったことは免責にならない
- AIの出力を貼ることは「引用」ではない。他人の著作物を載せるなら32条・48条の5要件を満たす
- EU AI法 第50条が2026年8月2日から適用。海外配信するならAI利用の開示を前提に設計する
ルールが曖昧だから止まる、ではなく、判断基準を持ったうえで速く回す。生成AIの価値は、そこではじめて出てきます。
※ 本記事は一般的な情報提供を目的としたものであり、法的助言ではありません。個別の案件については弁護士等の専門家にご相談ください。
AI活用のルールづくりから制作まで、まとめて相談できます.