この記事でわかること
- 著作権法30条の4が何を許していて、何を許していないのか
- 「享受目的の併存」と「ただし書」で、30条の4が使えなくなる場合
- RAG(検索拡張生成)や追加学習(ファインチューニング・LoRA)の扱い
- 無断学習を拒みたい権利者がとれる手段(robots.txt・技術的措置・規約・ライセンス)
- 企業が自社データで学習・RAGを組むときの確認事項と、EU AI法など海外の動き
AIの学習のための著作物の利用は、著作権法30条の4により原則として許諾なく行えます。ただし、学習データの表現を出力させる目的が併存する場合や、権利者の利益を不当に害する場合は対象外です。とくにRAGは、検索した文章が回答にそのまま出やすく、軽微な利用を超えれば原則として許諾が必要とされています。企業は「学習だから大丈夫」と一括りにせず、データの出所と使い方の組み合わせで判断してください。
著作権法30条の4とは|学習を原則として許す規定.
30条の4は、2018年の著作権法改正(平成30年法律第30号、2019年1月1日施行)で、デジタル化・ネットワーク化に対応した「柔軟な権利制限規定」のひとつとして設けられました(文化庁「著作権法の一部を改正する法律(平成30年法律第30号)について」)。条文の柱書きは次のとおりです。
著作物は、次に掲げる場合その他の当該著作物に表現された思想又は感情を自ら享受し又は他人に享受させることを目的としない場合には、その必要と認められる限度において、いずれの方法によるかを問わず、利用することができる。ただし、当該著作物の種類及び用途並びに当該利用の態様に照らし著作権者の利益を不当に害することとなる場合は、この限りでない。著作権法 第30条の4(柱書)/e-Gov法令検索
同条2号は「情報解析」の用に供する場合を挙げており、AIの学習はこの典型とされています。ここでいう「享受」とは、著作物を見たり読んだり聴いたりして、その表現から知的・精神的な満足を得ることです。AIの学習のように、大量のデータから特徴やパターンを取り出すための利用は、人が作品を楽しむためのものではない(非享受)ため、原則として許諾なく行える、という仕組みです。
「考え方」は、30条の4を含む柔軟な権利制限規定を設けた2018年改正の趣旨について、技術革新で大量の情報を収集・利用できるようになる中で、イノベーションの創出を促すため、著作物の市場に大きな影響を与えないものについて個々の許諾を不要にすることにあったと説明しています(「考え方」)。
30条の4が及ぶのは「学習段階」まで
30条の4で許されるのは、学習のためのデータの収集・加工や、モデルへの入力といった開発・学習段階の利用です。学習したAIで画像や文章を生成し、それを公開・販売する生成・利用段階は別に判断され、既存の著作物との類似性と依拠性があれば侵害になりえます。生成段階の考え方は生成AIの依拠性と著作権侵害の解説記事で詳しく扱っています。
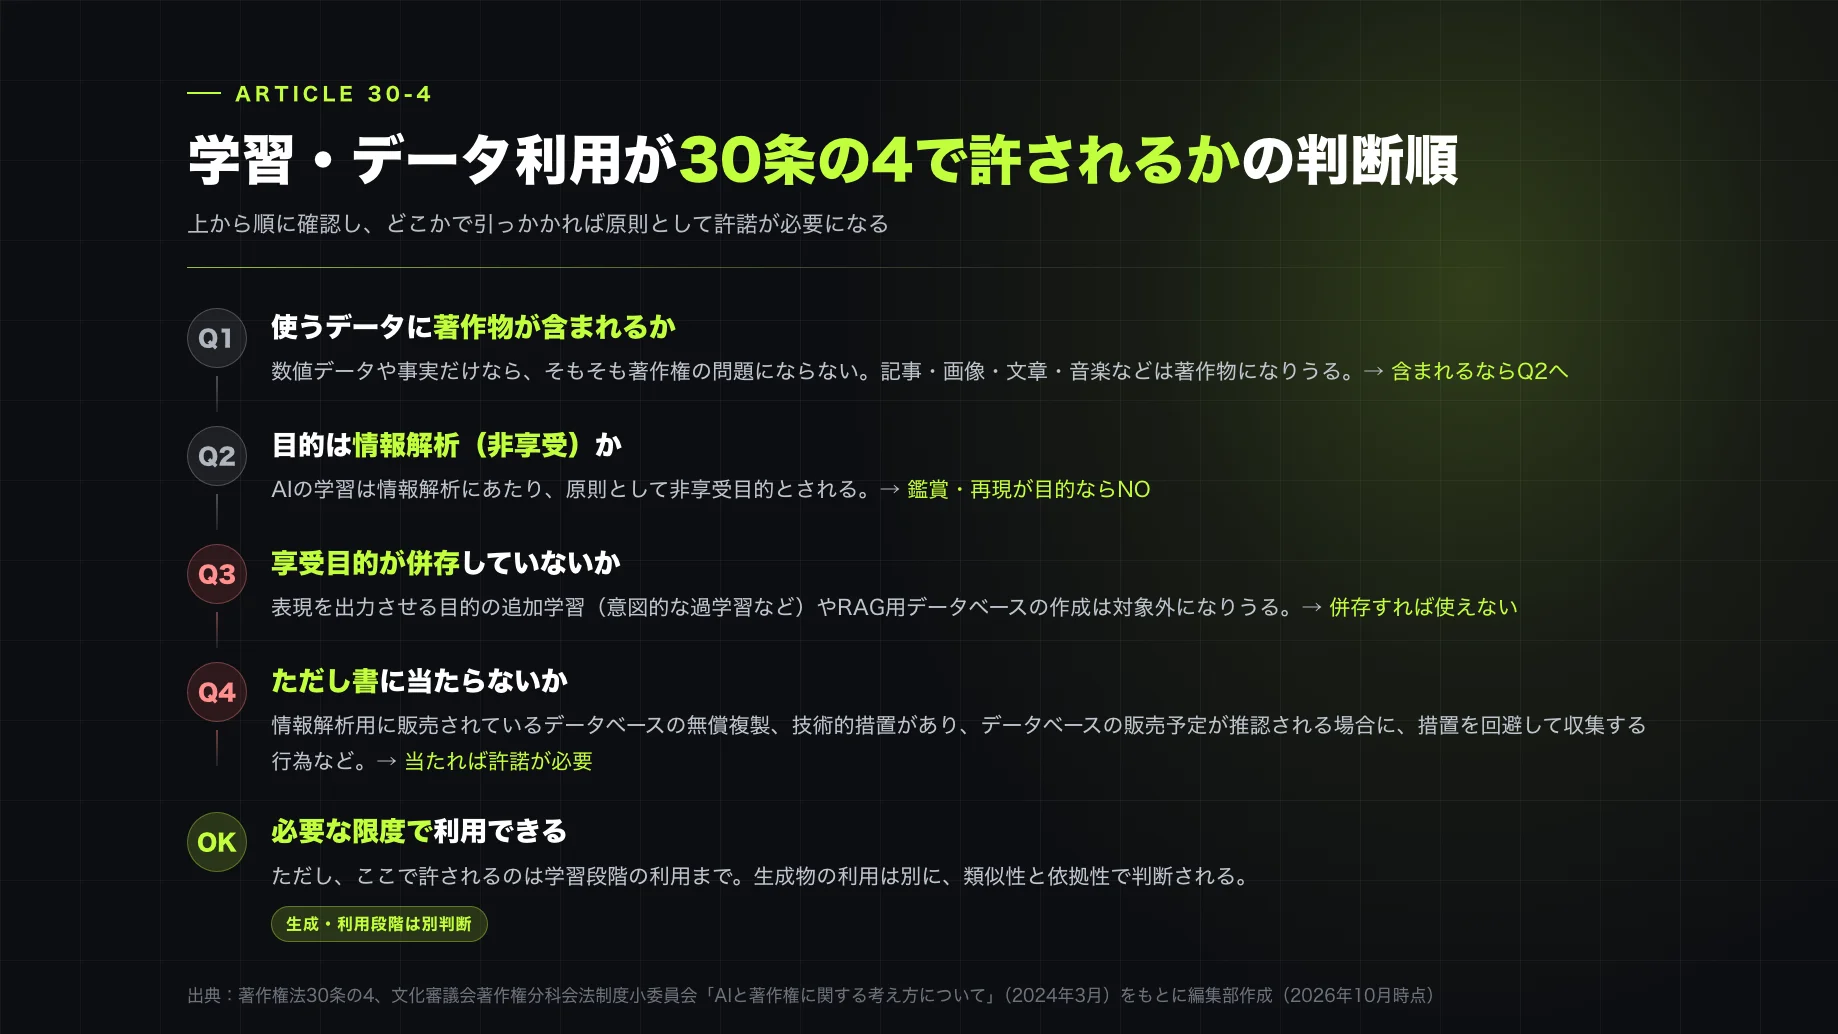
30条の4が使えなくなる2つの場合.
① 享受目的が併存する場合
30条の4は「享受を目的としない場合」に適用されるため、複数の目的のうちひとつでも享受の目的が含まれていれば要件を欠くことになります。「考え方」は、AIの開発・学習段階で享受目的が併存すると評価される場合として、次のような例を挙げています。
- 既存の学習済みモデルに対する追加学習のうち、意図的に、学習データに含まれる著作物の創作的表現の全部または一部を出力させることを目的としたもの(例:意図的な「過学習」。学習データをそのまま覚えて再現しやすくなる状態)
- 既存のデータベースやインターネット上のデータに含まれる著作物の創作的表現の全部または一部を、生成AIで出力させることを目的として、著作物の内容をベクトルに変換(文章を意味の近さで検索できる数値の並びに変える処理)したデータベースを作成する場合(RAGの一部)
また、出力させる意図まではなくても、少量の学習データで、その創作的表現の影響を強く受けた生成物が出るような追加学習を行う場合は、具体的な事案に応じて、創作的表現を直接感得できる生成物を出力することが目的と評価されれば、享受目的が併存すると整理されています。特定のクリエイターの作品だけを集めたLoRA(少量のデータで既存モデルを追加学習させる技術)が議論になるのは、この点です。
② ただし書(権利者の利益を不当に害する場合)
ただし書は、著作権者の著作物の利用市場と衝突するか、将来の潜在的な販路を阻害するかという観点から判断されます。「考え方」が示す代表的な例は次のとおりです。
| 場面 | 「考え方」の整理 | ポイント |
|---|---|---|
| 情報解析用に販売されているデータベース | 大量の情報を情報解析に活用できる形で整理したデータベースの著作物が販売されている場合に、それを情報解析目的で複製する行為は、ただし書に該当すると考えられる | 有償で提供されているものを対価なく使うのは典型的な例外 |
| 技術的措置が講じられている場合 | robots.txtなどで学習用クローラを制限し、過去の実績などから情報解析用データベースの将来の販売予定が推認される場合、措置を回避して収集・複製する行為は、ただし書に該当しうる | 技術的措置だけでなく、ライセンス提供の実績などとの組み合わせで判断される |
| 反対の意思表示だけの場合 | 権利者が反対の意思を示していることそれ自体をもって、権利制限の対象外とは解釈しにくい。意思表示のみでただし書に該当するとは考えられない | 「学習禁止」と書くだけでは足りない |
| 作風が似たものの大量生成 | アイデアが類似するにとどまる生成物が大量に生成されても、学習元の創作的表現と共通しない場合は、ただし書には該当しないと考えられる | ただし、この点には異なる見解もあると併記されている |
「考え方」は脚注で、技術的措置と情報解析用のライセンス提供を組み合わせている例として、The New York Times(米国)が自社サイトのrobots.txtでAI学習用クローラをブロックしつつ、別途テキスト・データマイニング(大量の文章から情報を抽出・分析すること)用のライセンスやAPIを提供している事例や、英国・ドイツの新聞社などの同様の取り組みを挙げています。権利者にとっては、単に拒否するより「有償で提供する道」を用意しておくほうが、法的な主張の材料になりうるということです。
RAGと追加学習はどう扱われるか.
企業の生成AI活用で増えているのが、社内外の文書を検索して回答に使うRAG(Retrieval-Augmented Generation:検索拡張生成)と、既存モデルに自社のデータを追加で学ばせる追加学習(ファインチューニングなど)です。この2つは、通常の事前学習とは分けて考える必要があります。
RAG|30条の4か、47条の5の「軽微利用」か
RAGを実装すると、検索対象のデータをベクトルに変換したデータベースを作る過程などで、著作物の複製が生じえます。「考え方」の整理は次のとおりです。
- データベースの作成に伴う複製が、回答の生成に際して、もとの著作物の創作的表現を出力することを目的としないものであれば、30条の4が適用されうる
- 創作的表現の全部または一部を出力することを目的としたものであれば、30条の4は適用されない
- その場合でも、回答の生成に際して既存の著作物を使うことには、47条の5第1項(情報の所在検索や情報解析の結果の提供に付随する軽微な利用)が適用されうる。ただし「軽微利用」に限られ、創作的表現の提供を主な目的とする場合は対象外
- 軽微利用の程度を超えて既存の著作物を使う場合は、原則として著作権者の許諾が必要
つまりRAGでは、回答に元の文章がどれだけそのまま出るかが判断を左右します。国内で新聞社が検索・要約型のAIサービスを訴えている事件(日本経済新聞社・朝日新聞社は、robots.txtで拒否の意思を示していたのに記事を取得されたと主張しています。Impress Watch 2025年8月26日)も、この領域の問題です。裁判の状況は生成AIと著作権の判例・裁判例まとめで整理しています。
追加学習|目的と出力で判断が変わる
追加学習も、学習である以上は原則として30条の4の対象です。ただし前章のとおり、特定の作品群の表現を出力させる目的が併存すれば対象外になりえます。自社の過去の制作物やマニュアルで追加学習する場合は問題になりにくい一方、他社の作品やウェブ上の特定の作家の作品だけを集めて追加学習するのは避けるべきです。
無断学習を拒みたい権利者の対応.
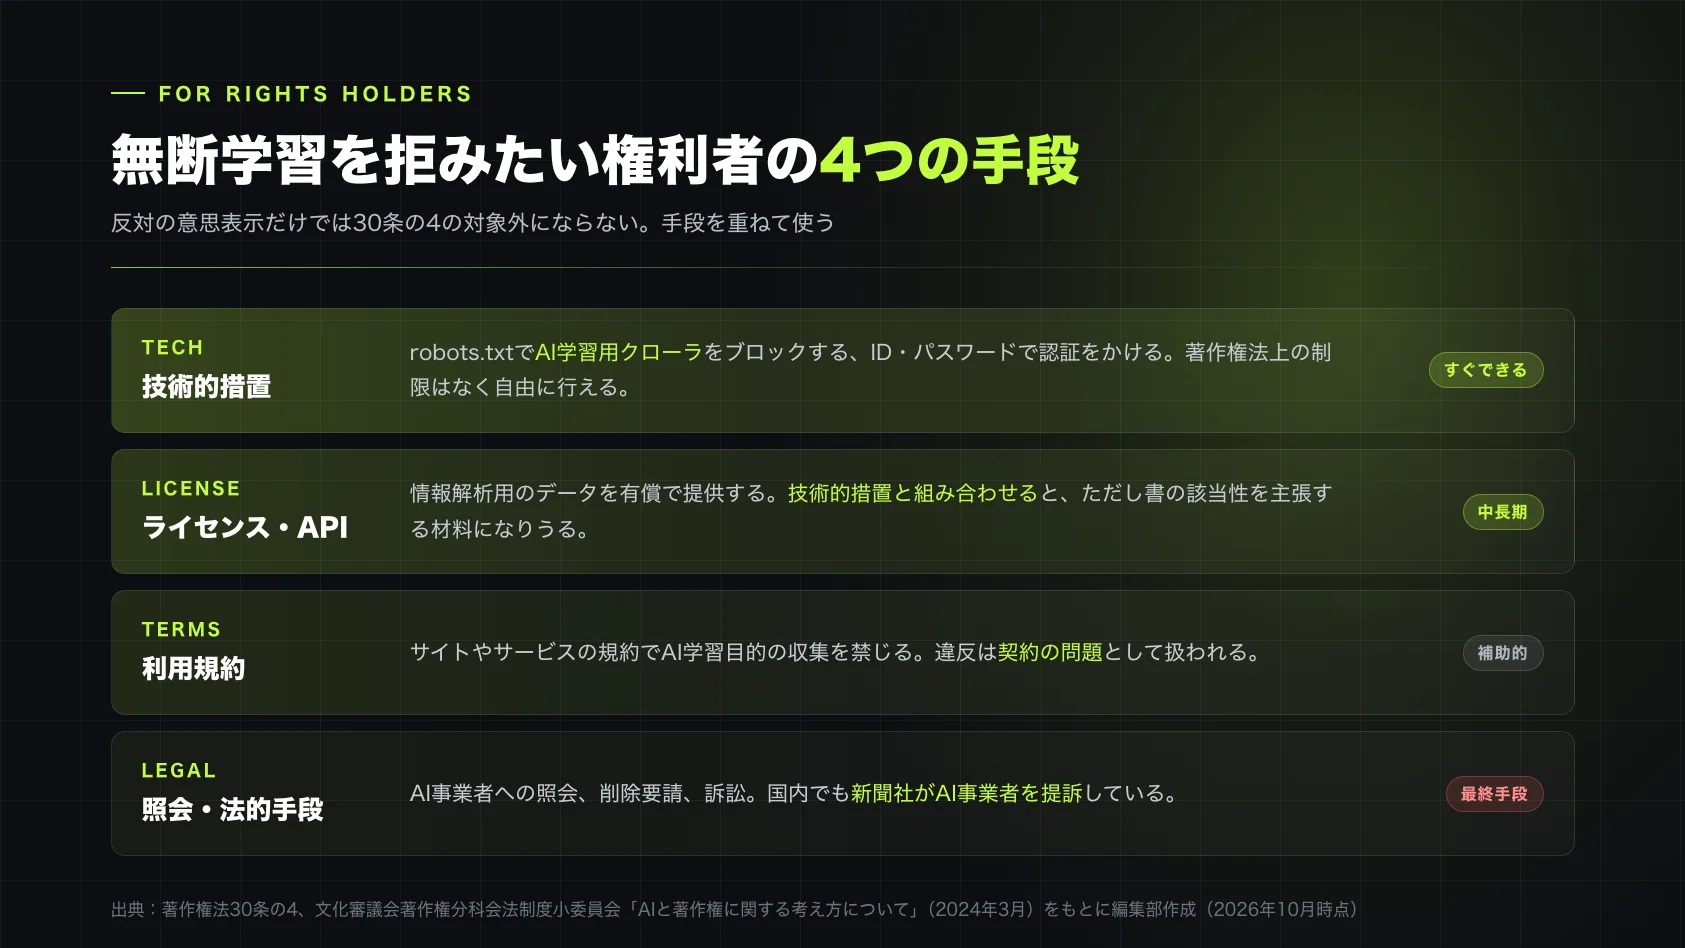
自社のコンテンツをAIの学習に使われたくない企業やクリエイターは、どうすればよいのでしょうか。前述のとおり、「学習禁止」と意思表示するだけでは、30条の4の対象外にはなりにくいと整理されています。そのうえで、「考え方」は、AI学習のための複製を防ぐ機械可読な技術的措置について、著作権法上の制限はなく、権利者やサイト管理者の判断で自由に行えるとしています。
robots.txtでAI学習用クローラを止める
robots.txtは、ウェブサイトのルートに置くテキストファイルで、どのクローラ(自動収集プログラム)にどのページの収集を許すかを書いておくものです。AI事業者の多くは、学習用データを集めるクローラの名前(ユーザーエージェント)を公開しており、その名前を指定してブロックできます。ただしrobots.txtは守るかどうかがクローラ側に委ねられた仕組みで、強制力はありません。
# AI学習用クローラの収集を拒否する例
User-agent: (AI事業者が公開しているクローラ名)
Disallow: /

# 通常の検索エンジンは許可する
User-agent: *
Allow: /
認証・規約・ライセンスを組み合わせる
- ID・パスワードによる認証:会員限定のコンテンツにすれば、クローラが自由に収集することはできなくなります。「考え方」も技術的措置の例として挙げています
- 利用規約:AI学習目的での収集を禁じる条項を置きます。これは著作権法ではなく契約の問題で、規約に同意した相手との関係で効力が問われるものです
- ライセンス・APIの提供:情報解析用のデータを有償で提供する道を用意します。前述のとおり、技術的措置と組み合わせることで、ただし書の該当性を主張する材料になりえます
国の動き|透明性と照会への対応
政府の「知的財産推進計画2026」(2026年6月)は、生成AIによる要約サービスとrobots.txtなどの技術的措置の関係について、ユーザーエージェントの開示やrobots.txtの遵守などの措置の在り方について課題を整理するとしています。また、生成AI事業者に学習データなどの情報開示や権利者からの照会への対応を求める「生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード」は、2025年12月に案の意見募集を経て、2026年8月25日に知的財産戦略本部が公表しました(法的拘束力のない原則)。コードを受け入れた事業者が受入れ表明を公表・届出する運用で、権利者が「自分の作品が学習に使われたか」を確認する手がかりになりえます。制度の流れは生成AIと著作権の法改正・制度整備まとめで時系列に整理しています。
企業が自社データで学習・RAGを組むときの注意.
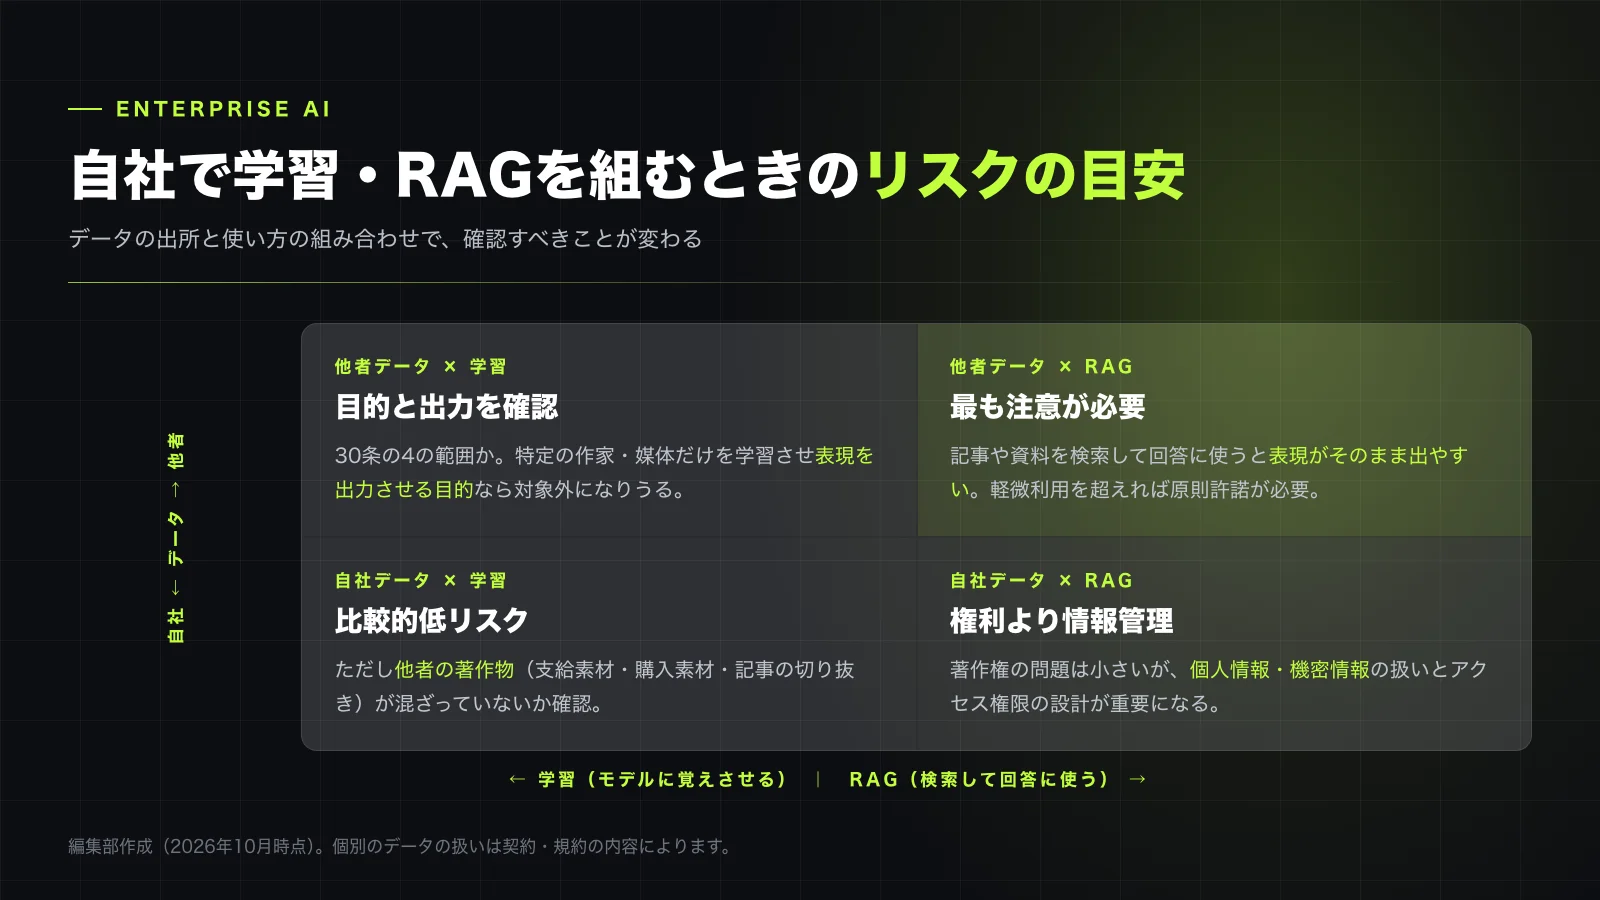
社内の文書でRAGを組む、過去の制作物で画像生成モデルを追加学習させる。こうした取り組みは、使うデータの出所と使い方によって確認すべきことが変わります。
データの棚卸しをする
「自社データ」の中に、クライアントからの支給素材、購入したストック素材、新聞・雑誌記事の切り抜き、外部の調査レポートなど、他者が権利を持つものが混ざっていないかを確認します。社内の共有フォルダには、思った以上に他者の著作物が含まれています。
契約・ライセンス条件を確認する
購入した素材やデータベースの利用規約が、AIの学習やRAGへの投入を認めているかを確認します。著作権法上は30条の4の範囲でも、契約で禁止されていれば契約違反の問題になりえます。
使い方を「学習」と「RAG」で分けて設計する
RAGで他者の文書を検索対象にする場合は、回答に原文がそのまま長く出ないよう、引用量の制限や出典表示を設計に入れます。軽微利用を超える使い方をするなら、権利者の許諾を取ります。
著作権以外のリスクも確認する
社内文書には個人情報や取引先の機密情報が含まれることが多く、学習・RAGへの投入は個人情報保護法や秘密保持契約の観点からも確認が必要です。アクセス権限のない社員がRAG経由で機密文書の内容を見られる、といった設計上の事故にも注意します。
記録とルールを残す
どのデータを、いつ、どのモデル・システムに入れたかを記録します。権利者から照会があったときに答えられることが、信頼の確保にもつながります。
生成AIを社内に導入する際のルール全体は生成AIの社内ガイドラインの作り方、導入の進め方は生成AIの企業導入の進め方も参考にしてください。
海外の動き|EU AI法は学習データの要約公開を義務化.
海外では、学習データについて日本より厳しいルールを設ける動きがあります。確認できた範囲で要点をまとめます。
- EU(AI法):EU AI法(規則2024/1689)の53条は、汎用AIモデルの提供者に対し、EUの著作権法を守るための方針を定めること(著作権者が機械可読な方法で示した権利留保=オプトアウトの尊重を含む)や、学習に使ったコンテンツの十分に詳細な要約を公開することを義務づけています。これらの義務は2025年8月2日から適用されており、欧州委員会は2025年7月24日に要約のテンプレートを公表しました。2026年8月2日からは欧州委員会の執行権限(制裁金を含む)が適用され、2025年8月2日より前に市場に出たモデルは2027年8月2日までに対応が求められます(欧州委員会)
- 米国:学習がフェアユースにあたるかは、個別の訴訟で判断が分かれています。米国著作権局は2025年5月9日に、生成AIの学習をテーマにしたレポートPart 3の公表前版を公開しています(米国著作権局)
EU向けにサービスを提供するAI事業者は、こうした義務への対応を進めています。日本企業がAIツールを選ぶ際も、学習データの要約や著作権方針を公開しているかは、比較の材料として使えます(編集部の見立て)。
よくある質問.
Q日本では、AIの学習に他人の著作物を自由に使えるのですか?
Qサイトに「AI学習禁止」と書けば、学習を止められますか?
Q社内文書でRAGを作るのに、著作権の許諾は必要ですか?
Q購入したストック素材で、画像生成AIを追加学習させてもよいですか?
Q自分の作品が学習に使われたかどうか、確認する方法はありますか?
まとめ|「学習だから大丈夫」と一括りにしない.
- 30条の4により、AIの学習は原則として許諾なく行える。ただし及ぶのは学習段階まで
- 享受目的の併存(表現を出力させる目的の追加学習・RAG)やただし書に当たれば対象外
- RAGは原文が回答に出やすく、軽微利用を超えれば原則として許諾が必要
- 権利者は技術的措置・規約・ライセンスを組み合わせる。意思表示だけでは足りない
- 企業はデータを棚卸しし、契約条件・個人情報・記録まで含めて設計する
AIで作ったものに自社の著作権が発生するかはAI生成物に著作権は発生するかの解説記事で整理しています。
参考にした一次情報:e-Gov法令検索「著作権法」 / 文化審議会著作権分科会法制度小委員会「AIと著作権に関する考え方について」(2024年3月15日) / 文化庁「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月31日) / 知的財産戦略本部「知的財産推進計画2026」概要 / EU AI法(規則2024/1689) / European Commission「Guidelines for providers of general-purpose AI models」
※ 本記事は一般的な情報提供であり、法的助言ではありません。個別の案件については弁護士等の専門家にご確認ください。記載は2026年10月時点の情報です。
自社データでの学習・RAG構築を、権利と情報管理の両面から設計します.